大模型应用的架构实践:从 RAG 到 Agent 编排
2026.07.13
大模型应用的难点从来不在调用模型,而在于如何把不确定性包装成可交付、可度量、可维护的工程系统。
很多人第一次做大模型应用时,会把它理解成一次 API 调用:把用户输入拼进提示词,把模型输出渲染到界面上;当演示效果还不错时,很容易产生「这件事已经做完了」的错觉;但从原型走到生产,中间隔着的恰恰是全部架构设计的部分——上下文怎么组织、知识怎么检索、调用怎么编排、失败怎么兜底、成本怎么收敛。
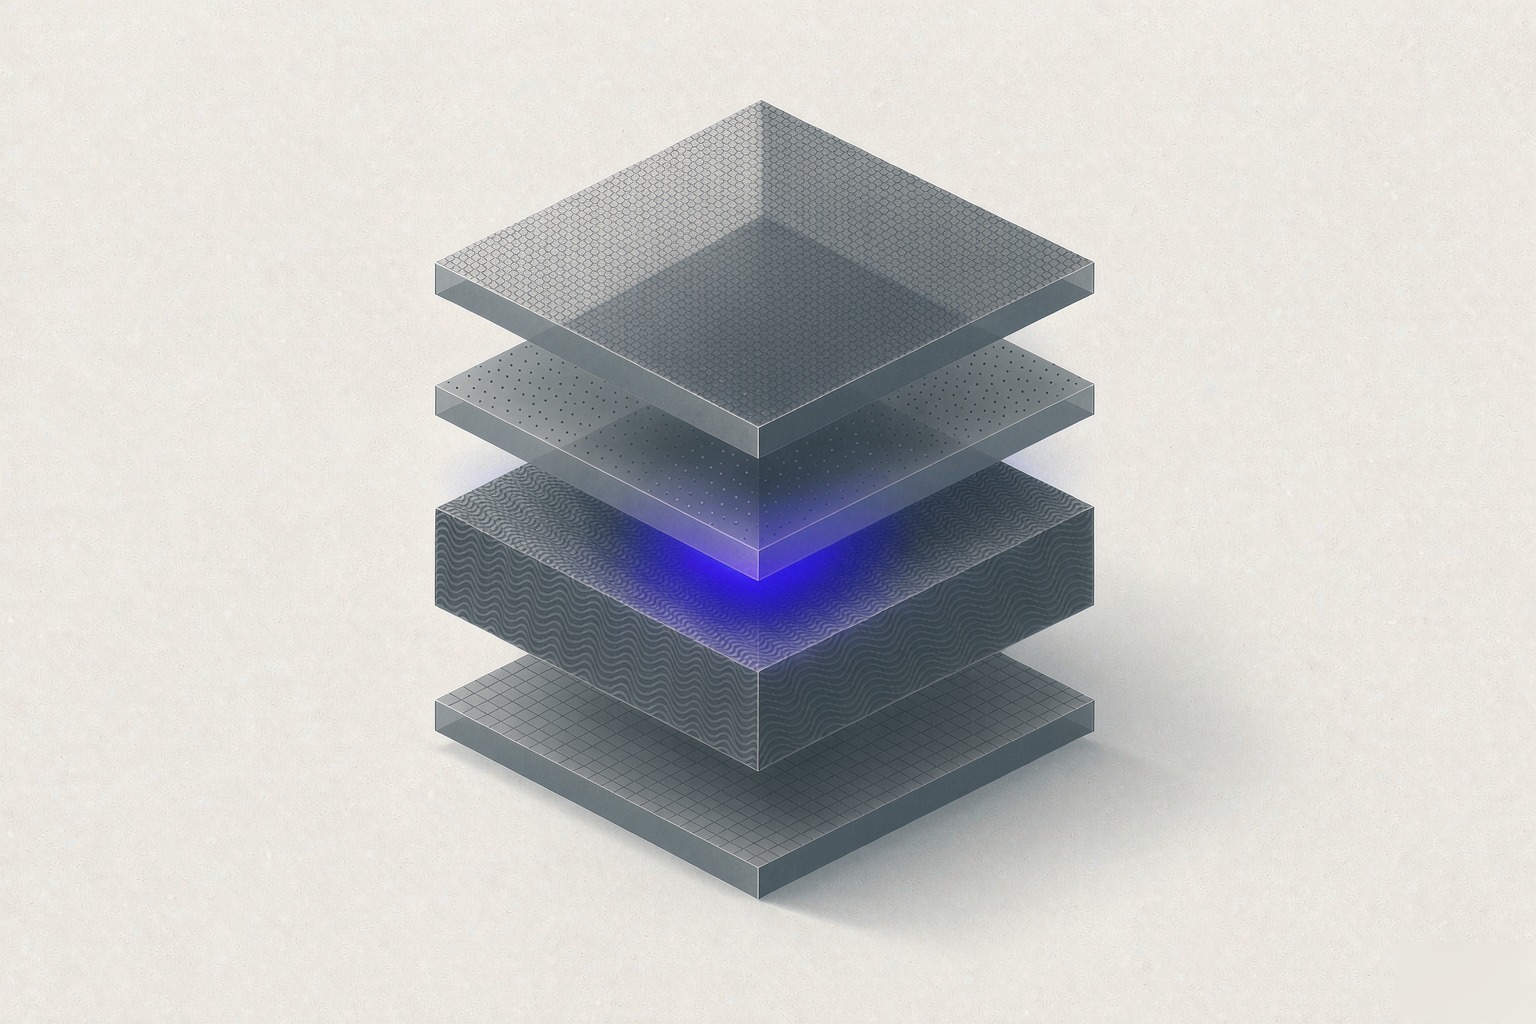
一、大模型应用的四层结构
把一个大模型应用拆开,大致可以分成四层,每一层解决一类不同的问题。
模型层负责能力供给,包括模型选型、微调、推理部署与配额管理;这一层的核心问题是「用哪个模型、以什么代价、在什么延迟约束下」;上下文层负责把该给模型的信息准备好,包括提示词模板、知识检索、历史对话压缩、工具描述,它决定模型「知道什么」;编排层负责决定下一步做什么,包括工作流编排、工具调用、多轮纠错、多智能体协作,它决定模型「怎么行动」;交付层负责把能力变成产品,包括接口设计、鉴权、限流、可观测性、人工介入通道,它决定这套能力「能不能被信任地使用」。
分层的意义在于定位问题:效果不好时,先判断是知识没给对(上下文层)、还是决策路径错了(编排层)、还是模型本身能力不足(模型层);不分层就只能在提示词里反复试探,那是玄学不是工程。
二、从提示词工程到上下文工程
早期大家谈「提示词工程」,关注的是措辞技巧:角色设定、思维链诱导、输出格式约束;这些技巧有效,但天花板很低,因为它们只优化了「怎么说」,没有解决「说什么」的问题。
真正决定输出质量的是上下文:模型看到的每一段内容——系统指令、检索到的文档片段、历史轮次、工具返回结果——共同构成了它的全部世界;因此上下文工程的核心动作是「筛选与组织」:在有限的窗口里,只放最相关的信息,并按对决策的重要性排序。
三个实践要点值得记住:一是信息密度优先于信息数量,塞进去十段无关内容,会把关键信息稀释掉;二是位置影响注意力,首尾位置的内容通常更容易被模型稳定使用,把决定性信息放在两端是一个稳妥的策略;三是上下文要可解释,当输出异常时,要能回放当时模型实际看到了什么,否则问题无法复现,也就无法修复。
三、RAG 的架构真相
检索增强生成是当前应用最广的模式,它的完整链路远不止「检索 + 生成」这两步。
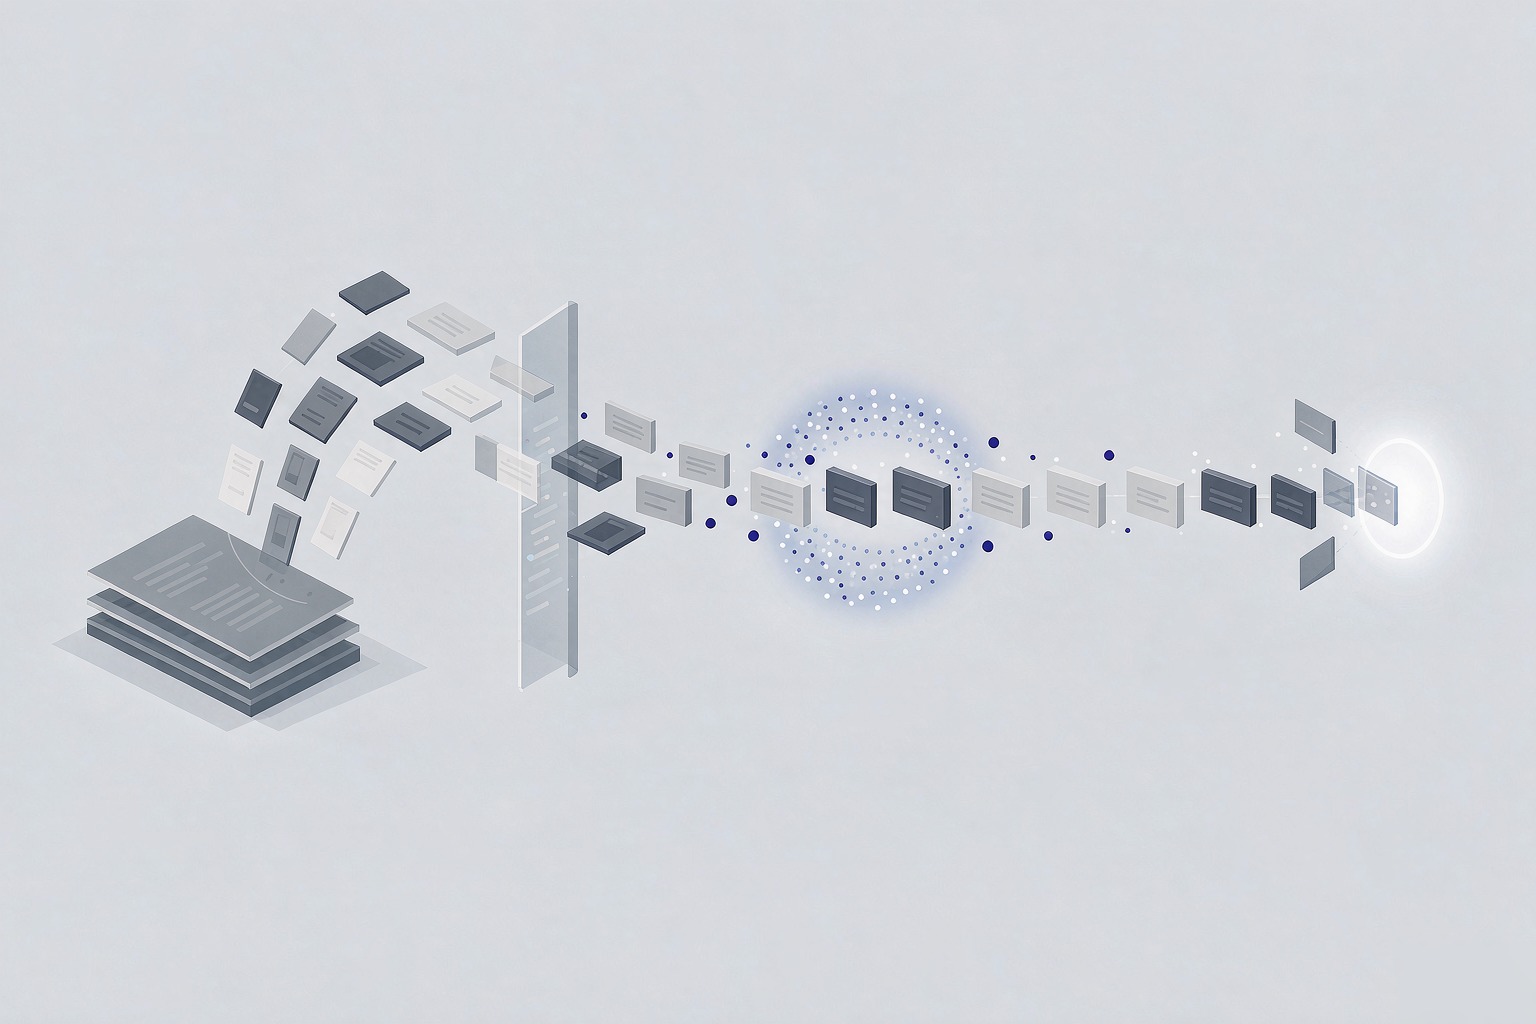
离线阶段要做的是索引构建:文档解析要去掉页眉页脚与导航噪音、按语义而不是按字数切分、为每个片段补充标题与来源元数据、生成向量并写入检索库、同时保留关键词索引用于精确匹配;这一阶段的质量决定了系统的效果上限,而它恰恰是最容易被草率对待的一步。
在线阶段要做的是召回、重排与生成:先用向量与关键词做混合召回,拿到一个较宽的候选集;再用重排模型对候选做精细排序,把真正相关的片段提到前面;最后才把精选片段与用户问题一起交给模型生成答案。
在工程上还有几个必须正视的问题:权限过滤必须在检索之前完成,否则越权内容会通过检索泄露;没有召回结果时不能强行生成,模型在没有依据时倾向于编造,正确做法是明确告知「未找到相关信息」或转人工;答案必须带出处,可点击的引用既是可信度的来源,也是排查问题的抓手;知识更新要有策略,文档变更后索引如何增量更新、失效内容如何下架,都需要提前设计。
四、Agent 编排的三种模式
当任务无法用一次问答完成时,就需要编排。
固定工作流是最可控的一种:把步骤提前定义好,模型只在每个步骤内做局部决策;它的优点是行为可预测、成本可估算、出错可定位,适合流程稳定、步骤清晰的业务场景,例如报告生成、单据审核。ReAct 循环让模型自主决定「思考—调用工具—观察结果」的往复:它灵活,但容易在复杂任务里打转,需要设置最大步数与超时作为保险。规划—执行模式先让模型产出完整计划,再逐步执行:它适合步骤较多、依赖关系明确的任务,代价是计划本身可能一开始就错了。
多智能体协作是更进一步的形态:把一个复杂目标拆给若干角色(检索者、分析者、校验者、汇总者),各自负责一段;它能提升复杂任务的成功率,但也会带来成本放大与冲突收敛的问题——每多一个智能体,就多一份不确定性和一笔 Token 账单,所以「用几个智能体」应当是一个成本收益判断,而不是炫技。
五、成本、延迟与可靠性
大模型应用有三个绕不开的工程约束。
成本方面,要做的不是省 Token,而是建立成本意识:把单次调用的 Token 数、单用户日均调用量、单业务线月度成本纳入监控,对长上下文与多次往复的场景设置预算上限;缓存是最高性价比的优化手段,相同或高度相似的问题命中缓存后,成本可以下降一个数量级。
延迟方面,用户对首字节的耐心远低于对总时长的耐心:流式输出能显著改善体感;把检索、重排、生成拆成可并行的阶段;对不依赖模型的环节(权限校验、参数组装)不要置于关键路径上;这些都是很朴素的性能工程,但在大模型场景里常被忽略。
可靠性方面,要用与传统系统一样的思路来兜底:设置超时与重试,但要区分可重试与不可重试的错误;对输出做结构化校验,格式不合规时触发一次受限重试而不是直接透传;当模型置信度低或多次失败时提供人工介入通道——一个设计良好的降级路径,比一个偶尔惊艳的模型表现更值得投入。
六、总结
大模型应用的架构,本质上是在用一个确定性的工程框架去包裹一个不确定性的能力内核:模型层选能力,上下文层给信息,编排层定路径,交付层保底线。
判断一个团队是否真的在做工程而不是在做演示,标准很朴素:能不能说清每一条链路的输入输出、能不能度量每一次调用的成本与延迟、能不能在效果变差时定位到具体环节、能不能在模型失效时优雅降级;做到了这四点,大模型才从一个新鲜的能力,变成一项可以被依赖的基础设施。